可能是 SOTA 的像素图修复开源方案
背景
上一期分享的图片转像素图的文章受到了很多关注,这周继续搞研究。
最近在像素图漫漫入门路上,遇到了两个痛点场景。
像素图临摹
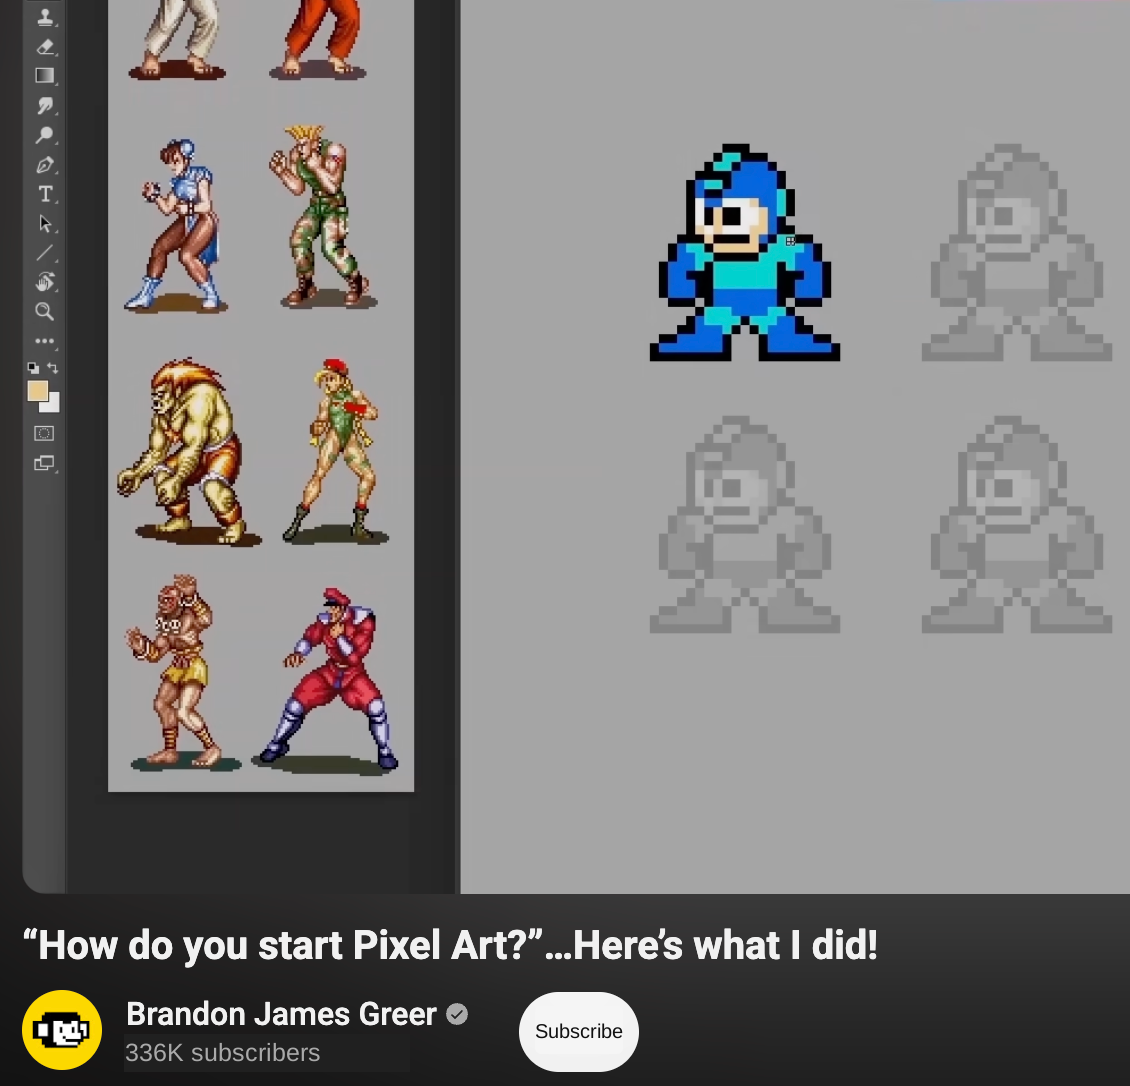
看到合适的像素图想要临摹练习,截屏或者下载的图片没法直接导入软件:
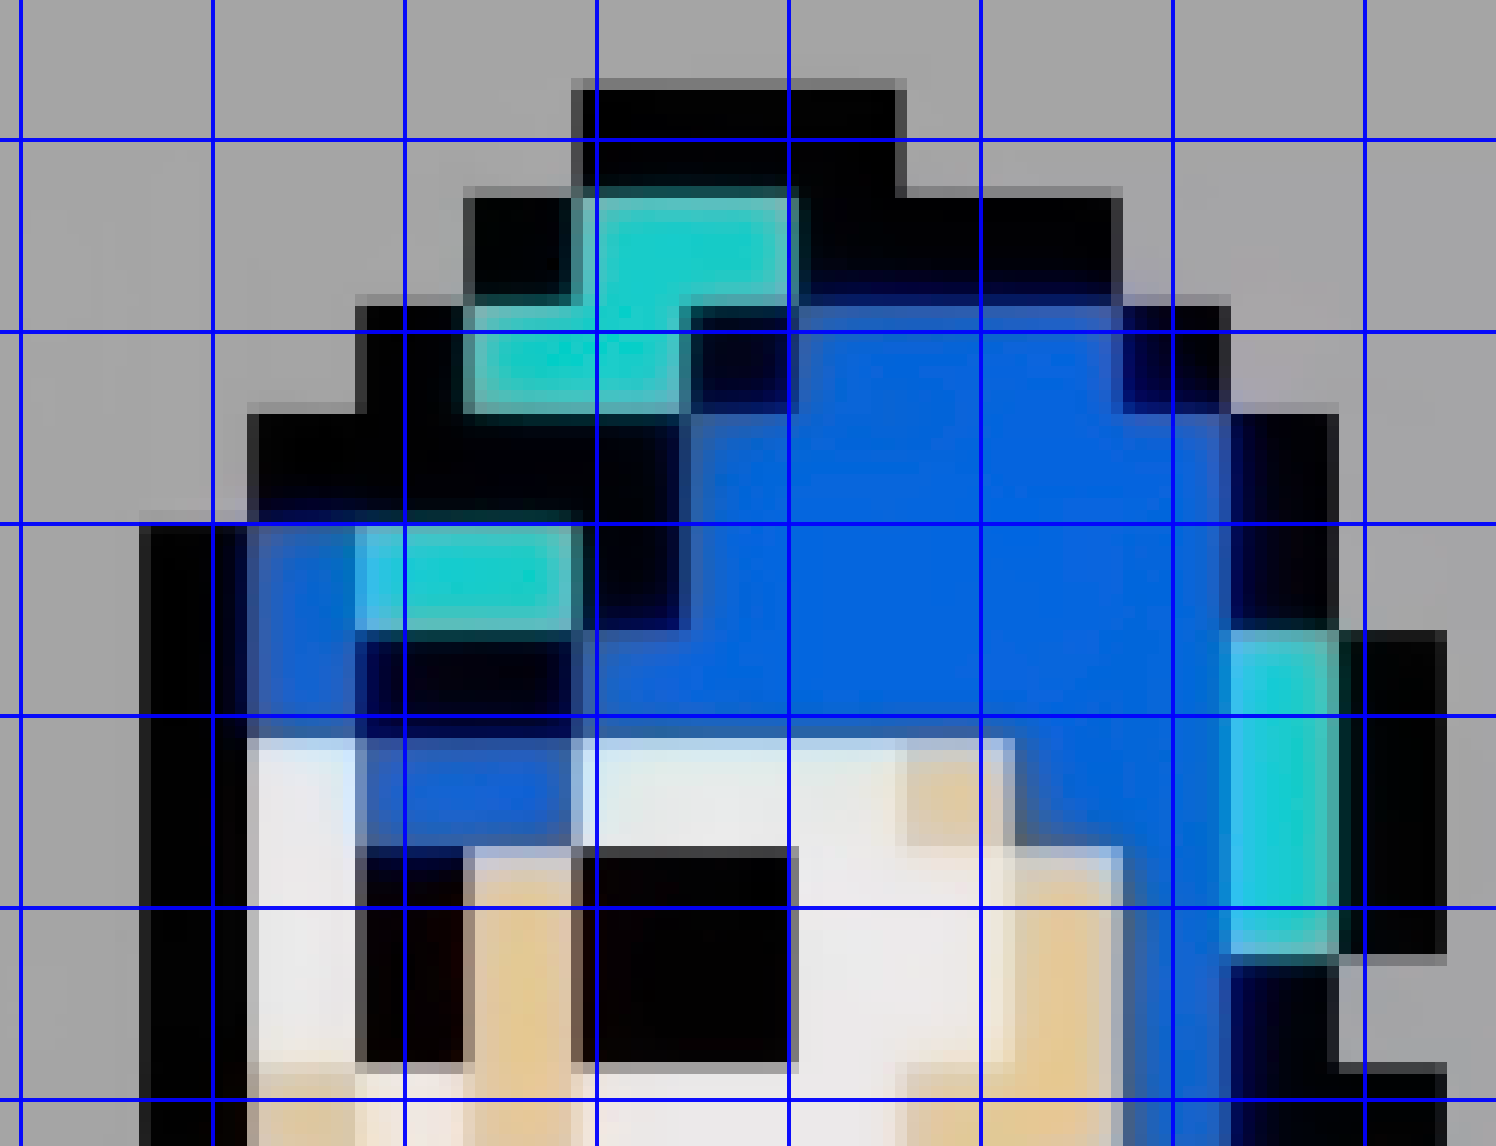
- 图片上的一个格子会对应多个像素点,不是真正 1:1 的
- 社交平台上的图片往往经过了平台压缩,像素格的边缘会出现伪影
AI 生图修复
下面是我用相同提示词在不同生图模型下生成的嘎子,其中除了 Seeddream 是不是看上去都像模像样的。
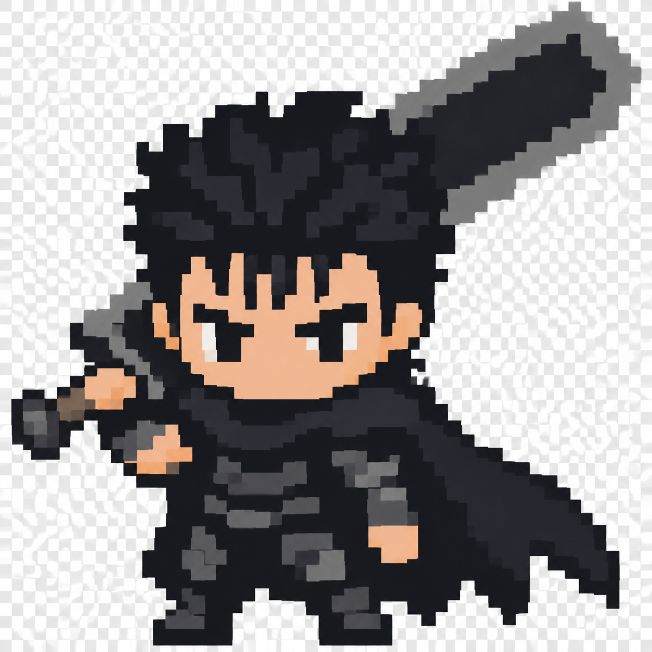
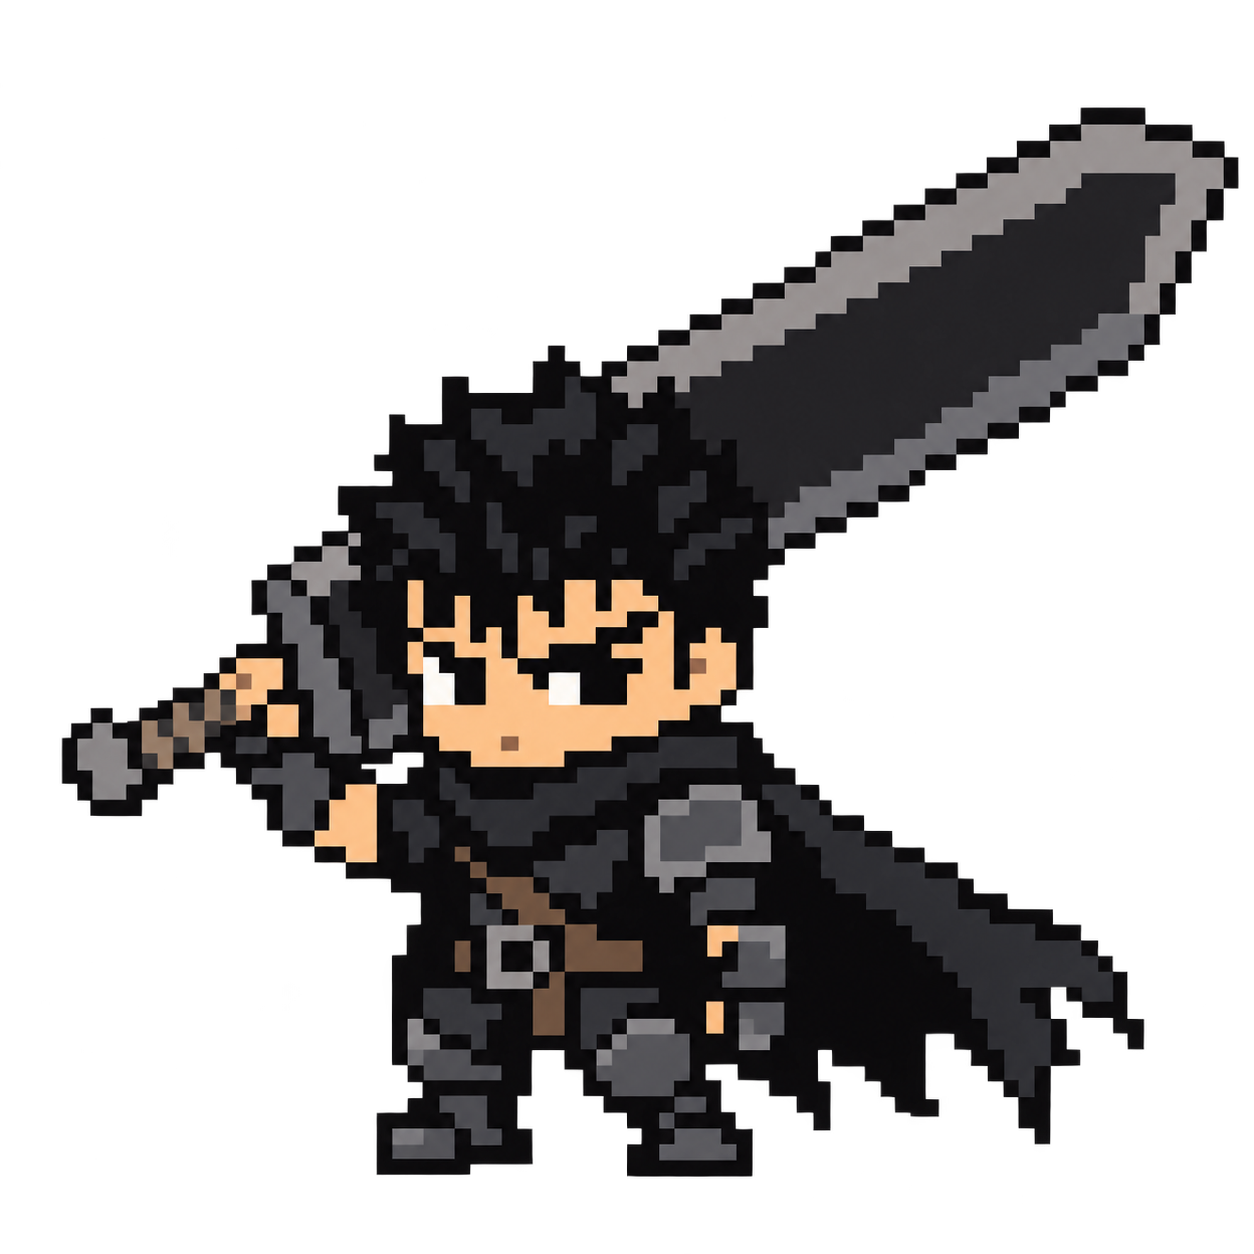
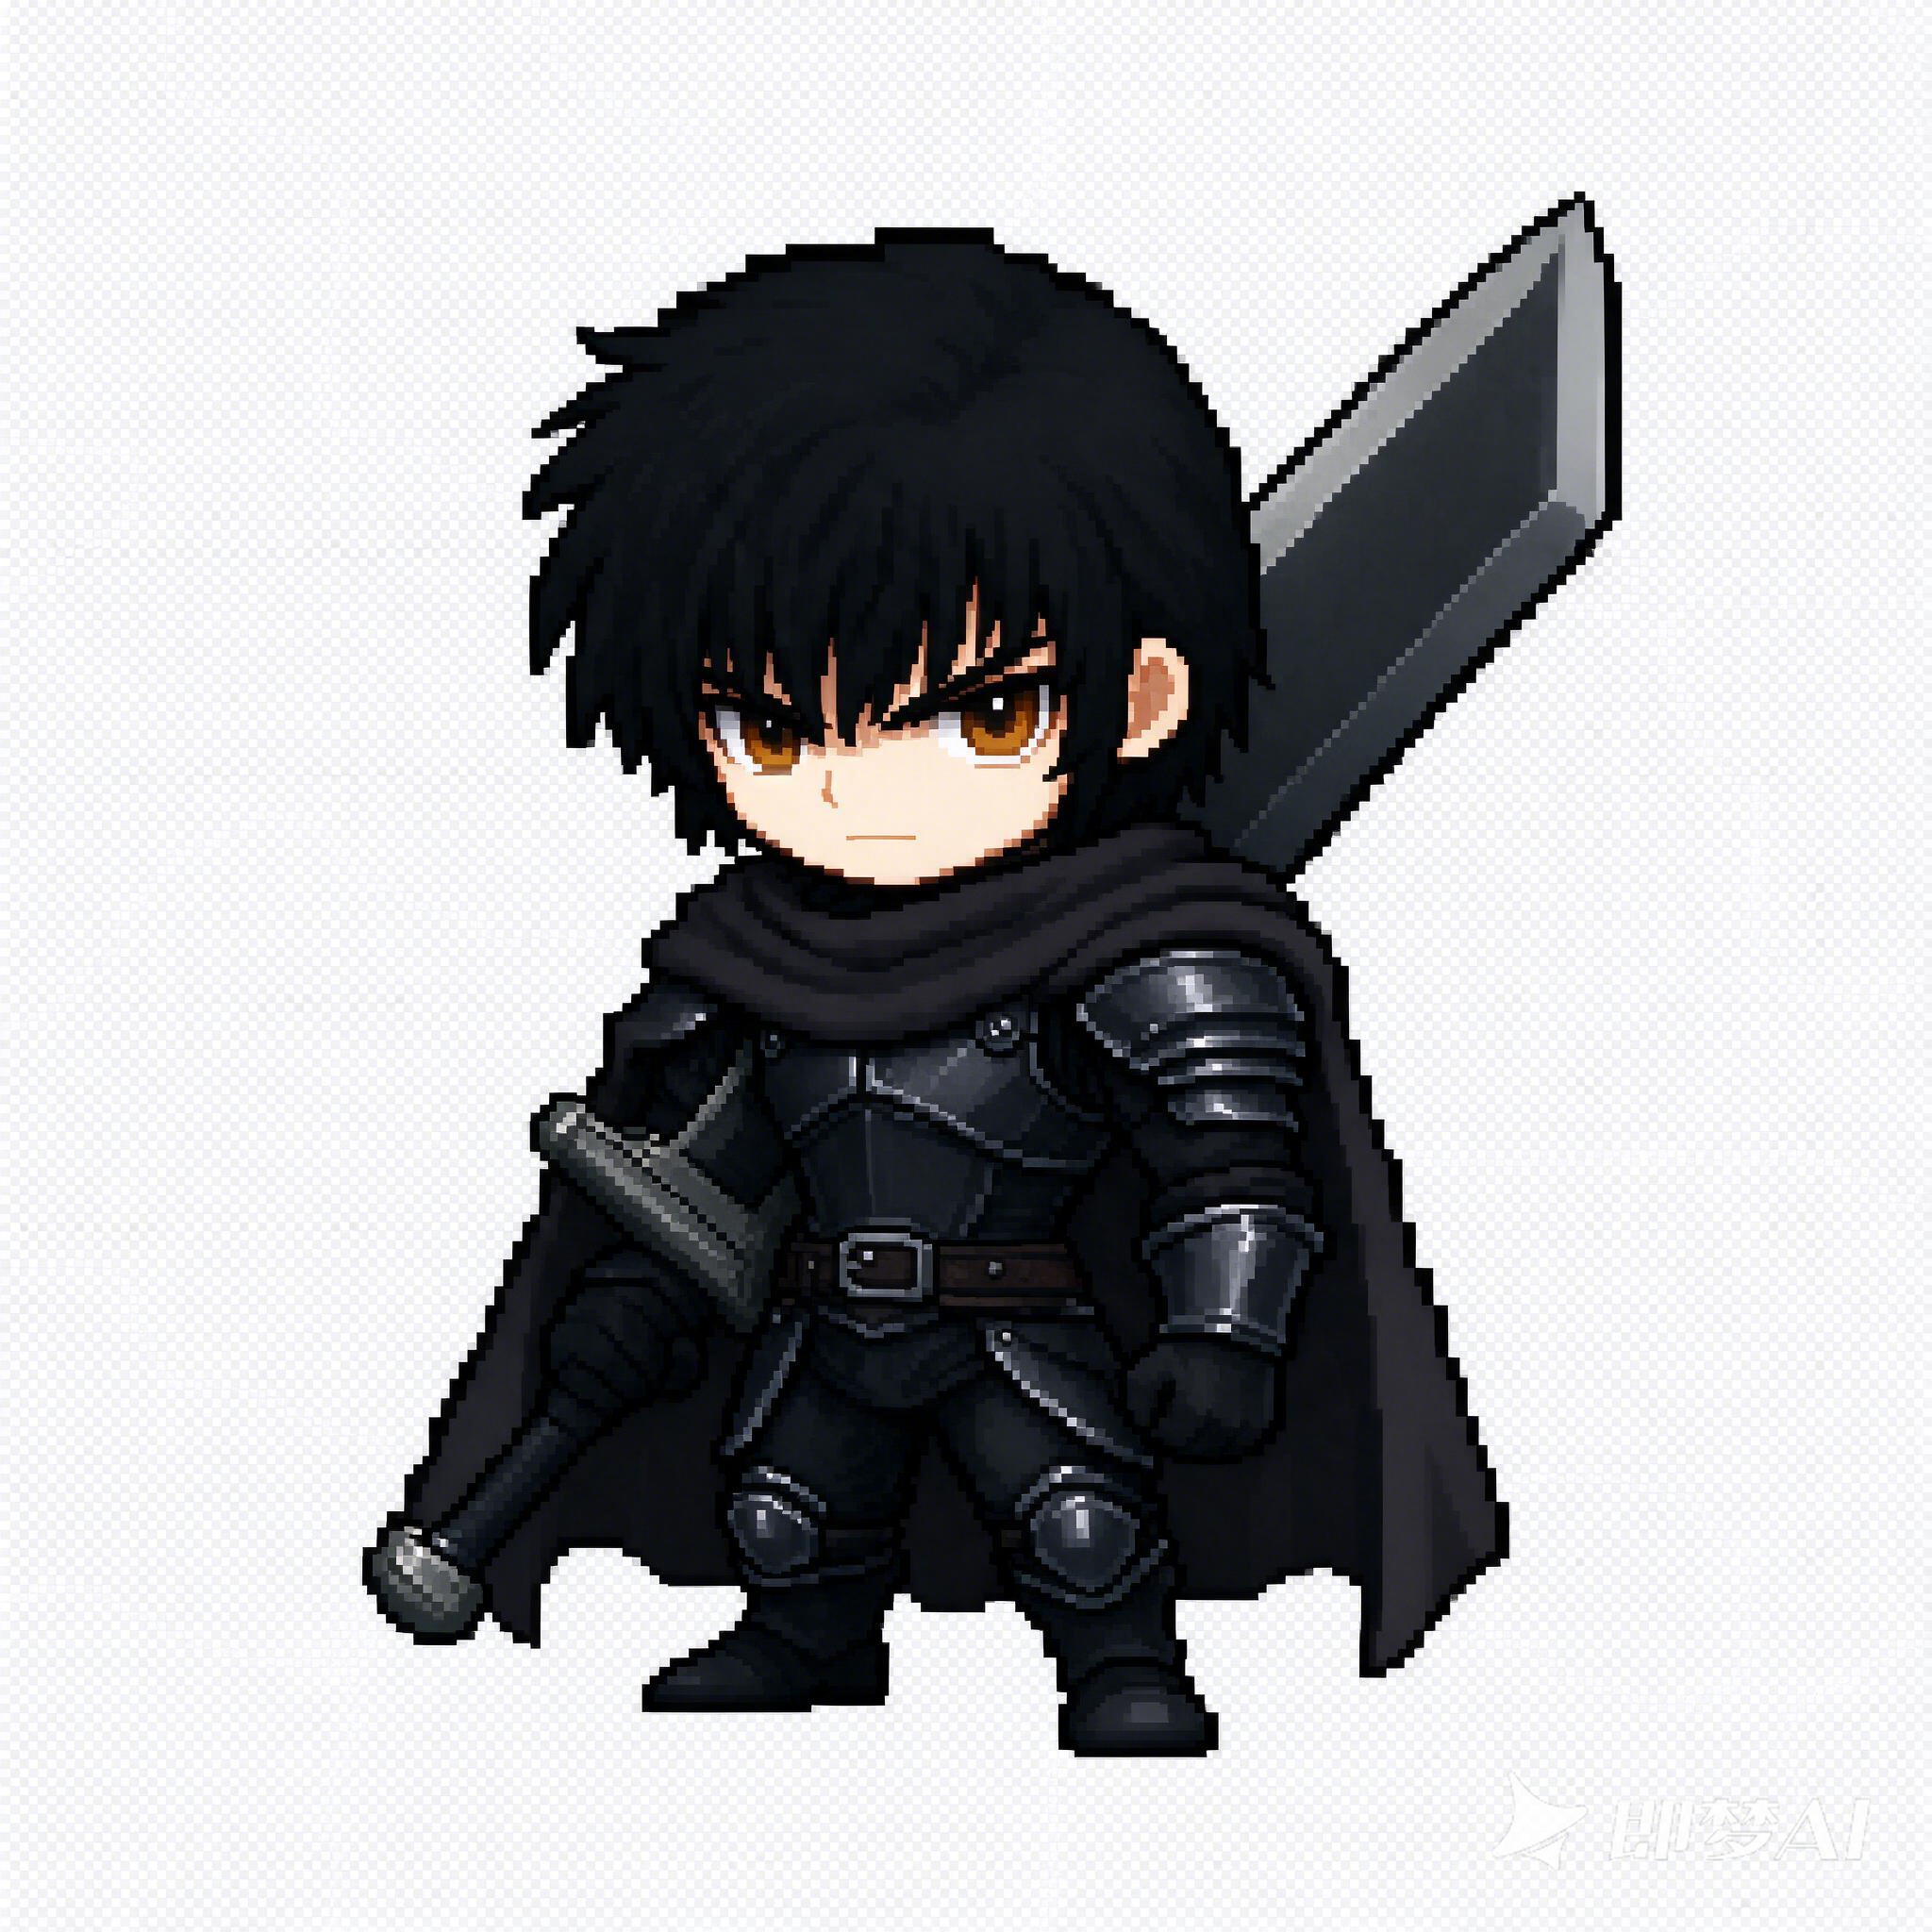
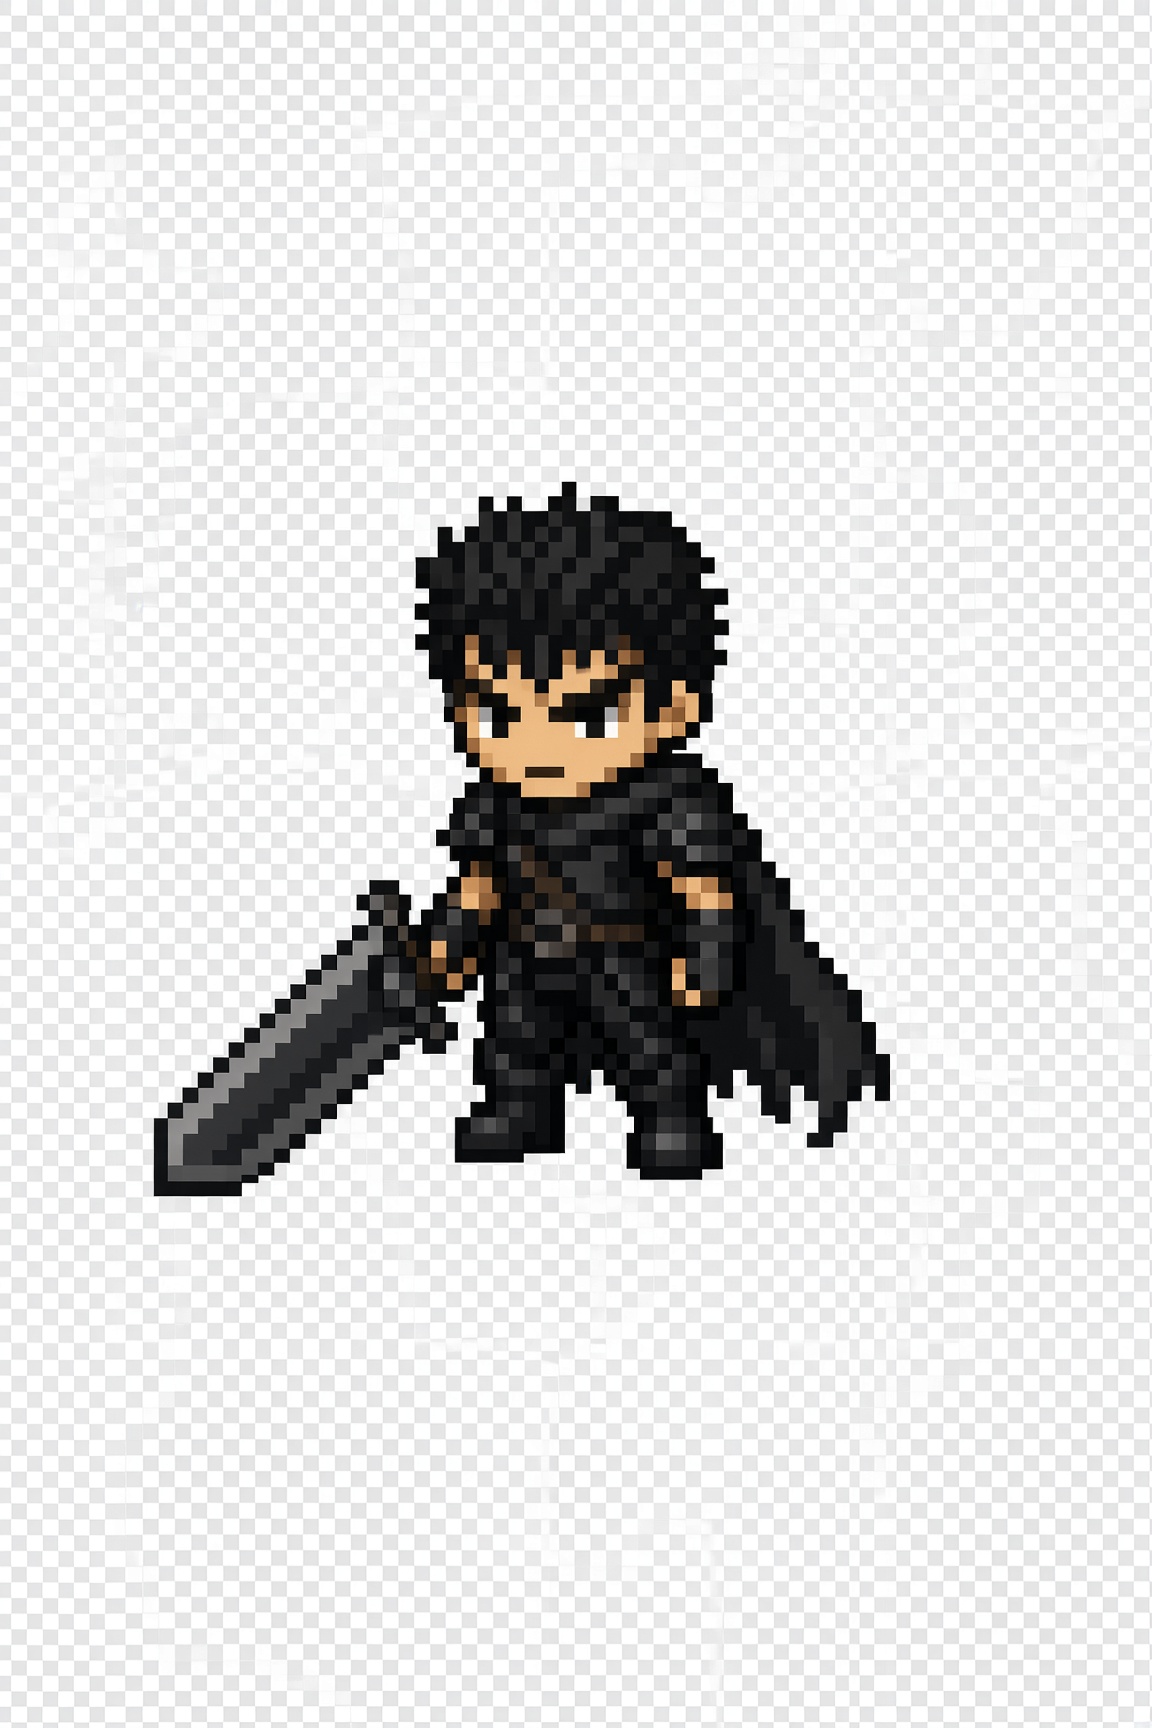
然而这些主流生图模型其实都无法生成真·像素图,放大看的话就能发现很多问题:
Nano Banana | GPT Image | Seedream | Grok | |
背景 | ❌ 伪透明棋盘格 | 真透明 | ❌ 伪透明棋盘格 | ❌ 伪透明棋盘格 |
半透明像素 | 无 | ❌ 有 | 无 | 无 |
留白 | 少 | 少 | 中 | ❌ 多 |
格宽漂移 | ❌ 13% | 7% | ❌ 19% | ❌ 14% |
格内杂色 | ❌ 3.6% | 1.4% | ❌ 3.2% | 2.9% |
格式 | ❌ JPEG | PNG | PNG | ❌ JPEG |
目标与大致思路
于是我想实现一个算法,输入是一些伪像素图,输出是真像素图。
而我之前遇到的问题大致可以分为两类:
- 网格问题:像素格子的尺寸和偏移不对齐
- 颜色问题:色彩杂乱,通常的像素图色盘往往只有少数几个颜色。
因此可以一个管线表示:
第一步:网格还原
调研
让我们看看现在主流的一些开源解决方案是怎么做的。先给个完整图片:
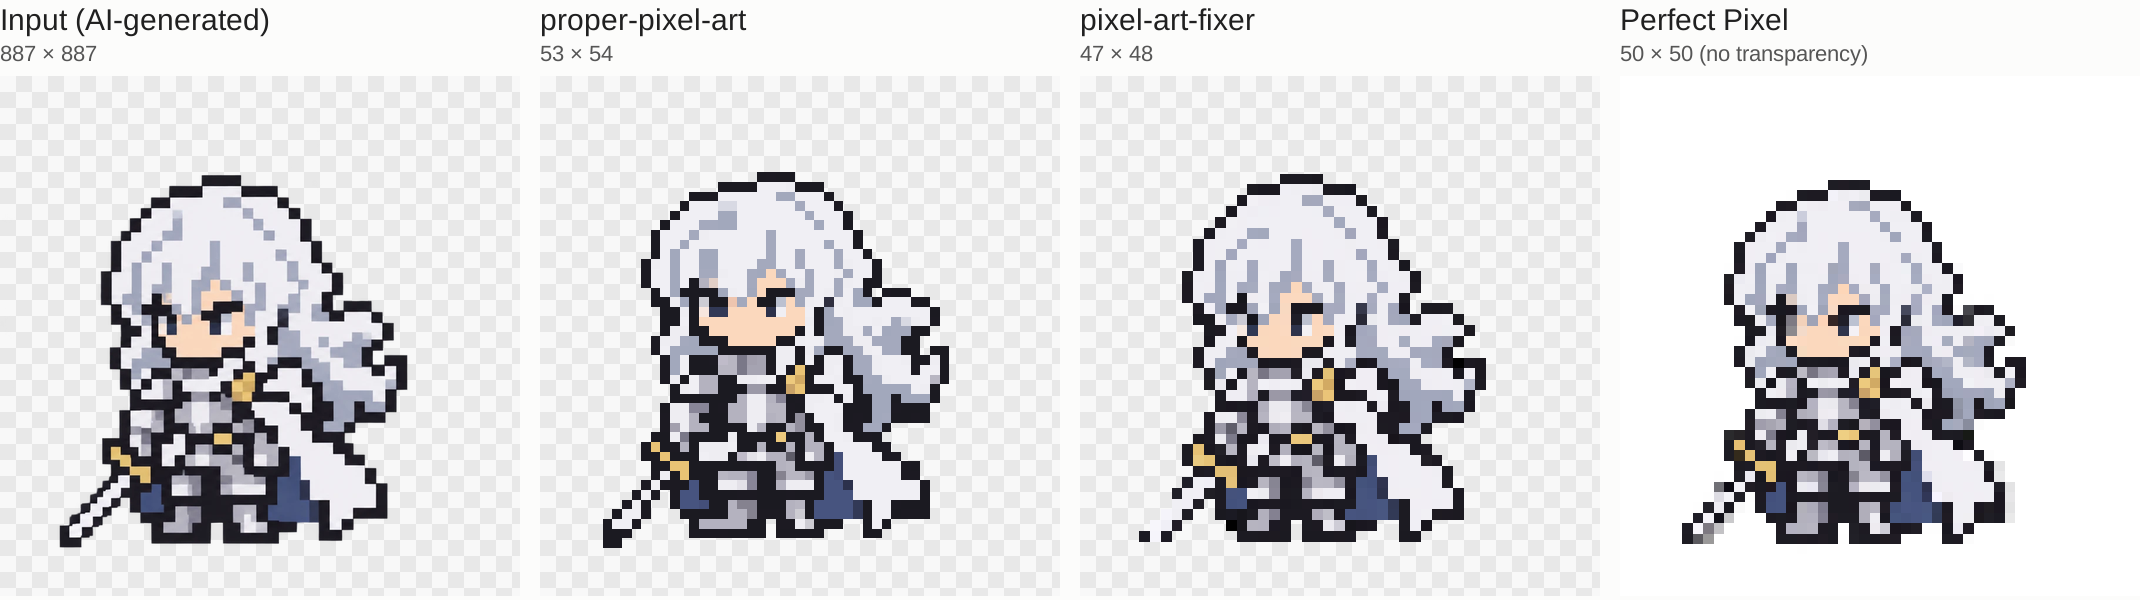
proper-pixel-art
proper-pixel-art 是 Kenneth Allen 做的开源库(MIT):核心思想是用 Canny + 霍夫线恢复网格,再落到真分辨率。
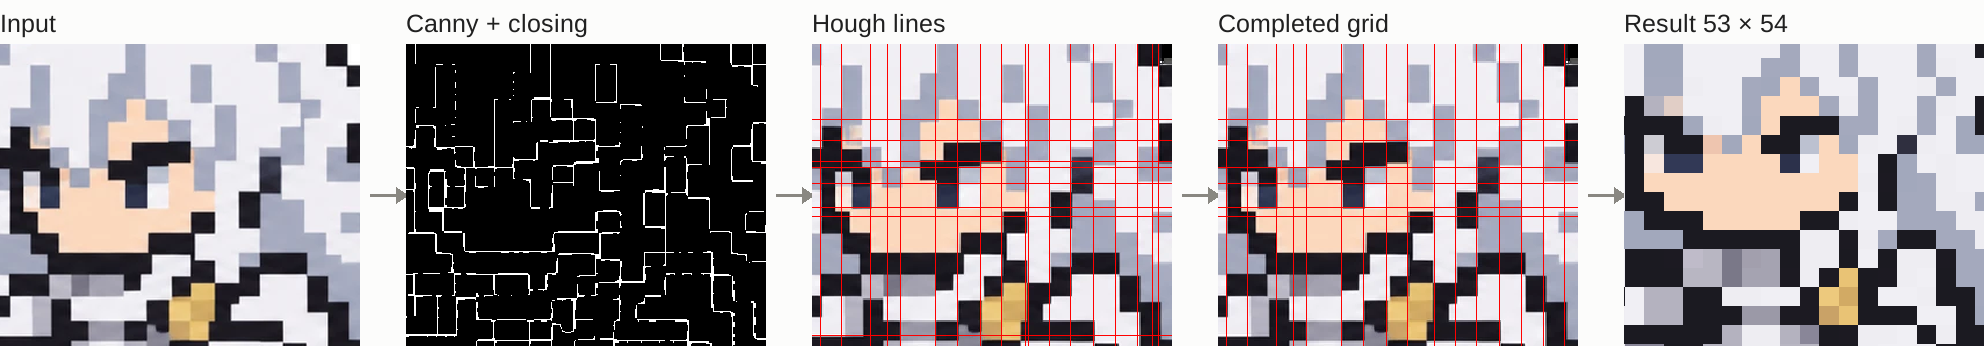
在网格恢复上,proper-pixel-art 经过了以下的流程:
- Canny 找边:先用 Canny 边缘检测加一次形态学闭运算把边连起来
- 概率霍夫线:再用概率霍夫变换找直线段,只留下接近水平或接近竖直的那些(偏差 15° 以内),当作格子线的初稿。
- 吸附投影峰:把每条已经找到的线微移到附近最高的投影峰上。这一步主要修改线的位置,不增减格线。
- 补齐网格:用间距中位数当格宽,在稀疏处插入缺线。
流程看起来合理,但在部分场景上仍有问题:
- 多斜边场景初稿稀疏:霍夫要求线段至少 50 像素长、投票数过阈值。对于边缘是斜线或曲线的场景,能抽出来的长直线有限,会导致初稿非常稀疏,指导作用有限。
- 格宽被取成整数:由于使用的数据类型是
int,即便先放大 2 倍再找线,折回原图只能是 0.5 的倍数。
在格里菲斯图场景下:
- 格宽取整成 17 px(真实约 18.5 px),画出部分被切成 37×40 格,比实际多出 4 列、5 行左右。
- 它在每两条初稿线之间各自等分,有些地方切出 8 px 的窄格。同一个画出的像素会被切成一窄一宽两格,输出就出现双像素(比如眼睛部分)。
pixel-art-fixer
pixel-art-fixer 由 Retro Diffusion 维护(开源,MIT):三路与相位无关的格宽检测先投票,意见不一时用证据栈仲裁,再把「放置」和「上色」分开重建。有 Rust 实现,很快。
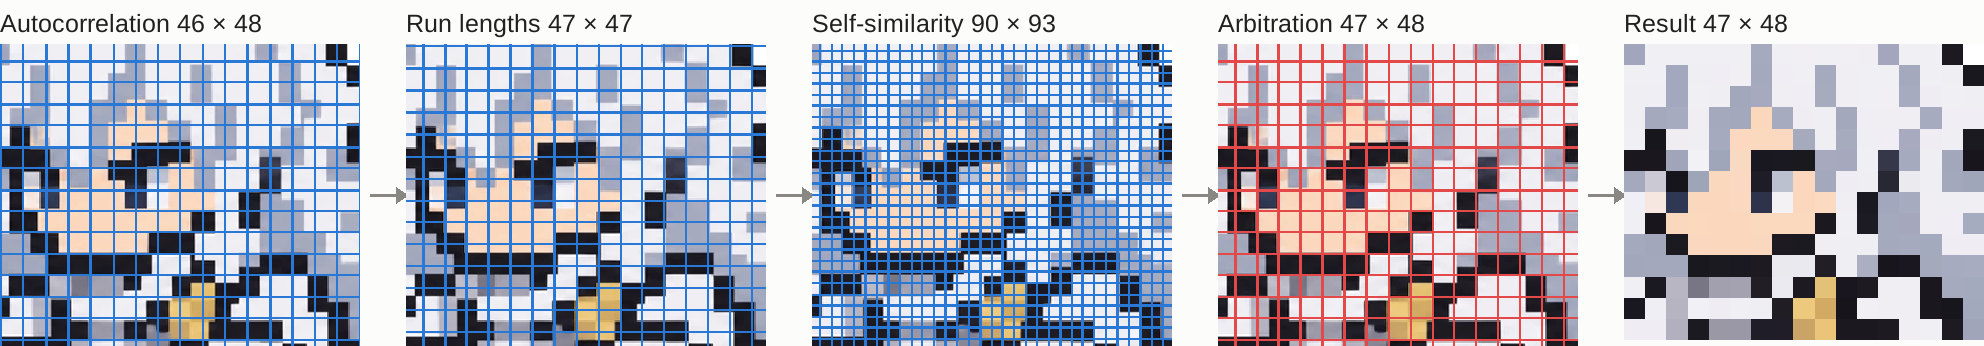
- 候选算法
- 自相关(autocorr):看图在平移多少像素后最像自己,找重复间距
- 游程梳(runlengths):统计同色连续段长度,找重复间距
- 自相似(selfsim):比局部块在候选格宽下是否重复出现
- 仲裁因子
- 融合频谱证据:看频域里哪个格宽峰更稳
- 格内方差对比:格内越平、格间差越大越好
- 倍频清理:排除半格、两倍格等假峰
fixer 的格宽找得很准,但它的问题在于:
- 整张图只用一套等宽的格子:从左边缘按同一宽度等分,没有相位,也不对单条切割做吸附。当切割线穿过轮廓像素格中间的时候,就容易丢失细节,比如图中左眼边的轮廓线就消失了。
Perfect Pixel
Perfect Pixel 是 theAmusing 做的开源库(MIT):用 FFT 估格数,Sobel 把格线吸到边上,再按格取样。
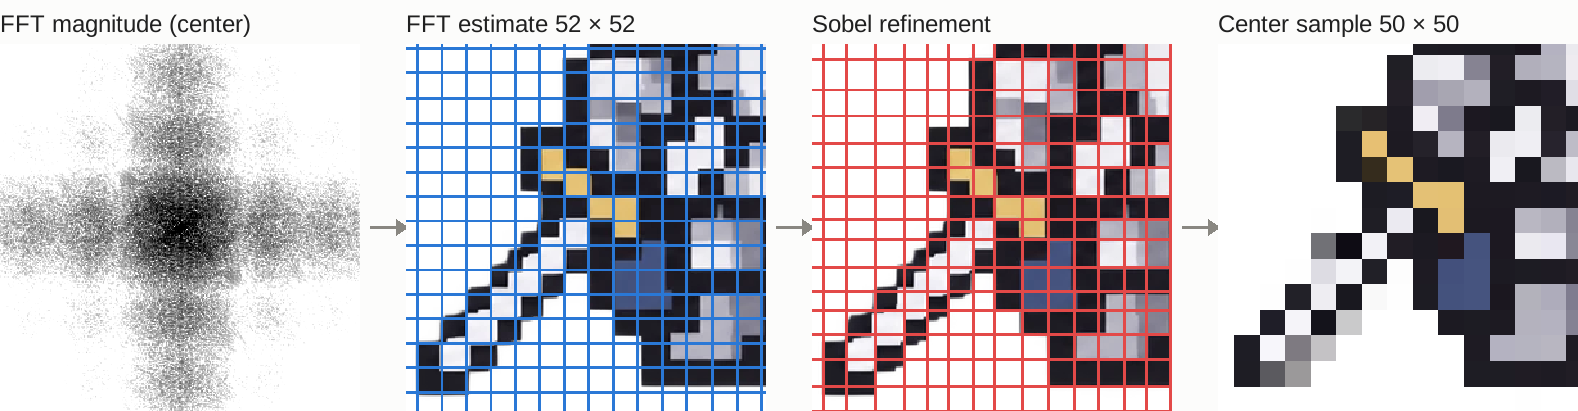
- FFT 估格数:对灰度图做 FFT,在行列投影上找峰,得到整数格数;失败时退到梯度峰间距的中位数。
- Sobel 精修:每条格线在 ±25% 格宽内吸到最强的边上。
- 按格取样:默认取格子中心像素。
问题也集中在这里:
- 整数格:和 proper 一样,小数格宽会被拧歪。
- 无透明通道:透明底被当成白色,不仅如此,透明图的轮廓附近也会留下灰白杂点。比如单手剑边缘附近就出现了很多杂色像素。
我的方案
既然每个方案或多或少都有点问题,我决定站在巨人肩膀上,再取长补短,缝合出一个更好的方案来。
取长:
- 多路候选 + 裁决结构(Fixer)
补短
- 需要被决策的不能只是格宽,最好是整个网格(Fixer)
- 格宽需要支持浮点数(Proper、Perfect)
- 需要对半透明像素进行二值化处理(Perfect)
然后我就把这个思路扔给了 AI(前后转手了 grok、codex、claude 并与它们大战了两周),历经坎坷地得到了下面的一套解决方案:
看着很复杂,不过通俗点讲的话,可以理解为一个擂台赛。
- 海选
- Round #1:淘汰过细的网格
- 用晋级选手的格宽派出几位跟着边走的外卡
- Round #2:然后所有选手和擂主「原图」同场打分
- Round #3:复活赛,让多方投票支持的尺寸有机会翻盘
比如在格里菲斯这个图上,就是基于 Pitch 的边缘路径外卡选手取得了最终的胜利✌️:
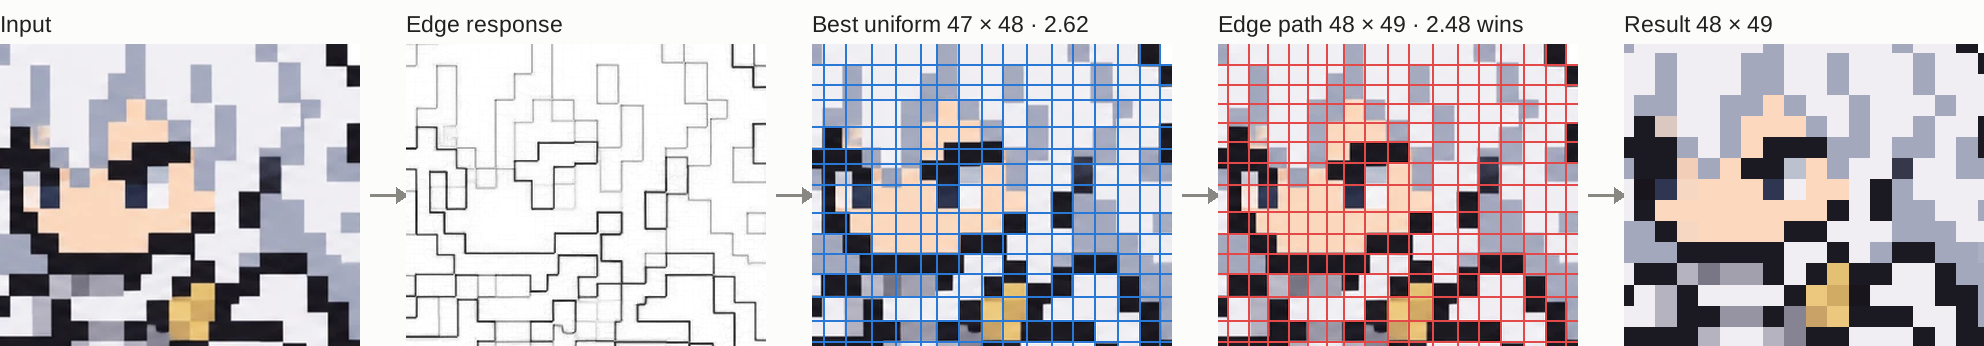
简单介绍下原始参赛选手和三轮的评委:
选手 | 怎么提出网格 |
Uniform | 把颜色边按列、按行叠加,找一套等宽格 |
Edge | 把每条切割线钉在清晰的颜色边上,格宽可以不等 |
Frame | 假设整张图是 n 格均匀放大,把每个 n 都试一遍 |
Pitch | 搜格宽和第一条线的位置,先粗搜再细搜 |
Comb | 找颜色变化的重复周期 |
Boundary | 数图片边缘同色连续段的长度 |
Distance | 量同一行里相邻两条颜色边的距离 |
评委 | 评价 |
#1 边缘一致性 | 衡量颜色边落在切割线上的比例。如果存在格宽至少大 1.5 倍、一致性又明显更高的网格,较细的网格就被淘汰 |
#2 描述长度 | 得分 = 编码信息量 − 相位证据 + 倍频惩罚,越低越好 |
#3 投票 | 冠军只由一路提出,而相差一格的尺寸有多路支持、得分也接近时,改用后者。 |
第二步:颜色选取
网格定好以后,下一件事是给每一格定颜色。无论是截图还是 AI 生图,格子里通常都有杂色。一格里往往有一百多个源像素。颜色选取就是从这些源像素里定出一个代表色,写进输出图的那一格。
取色方式
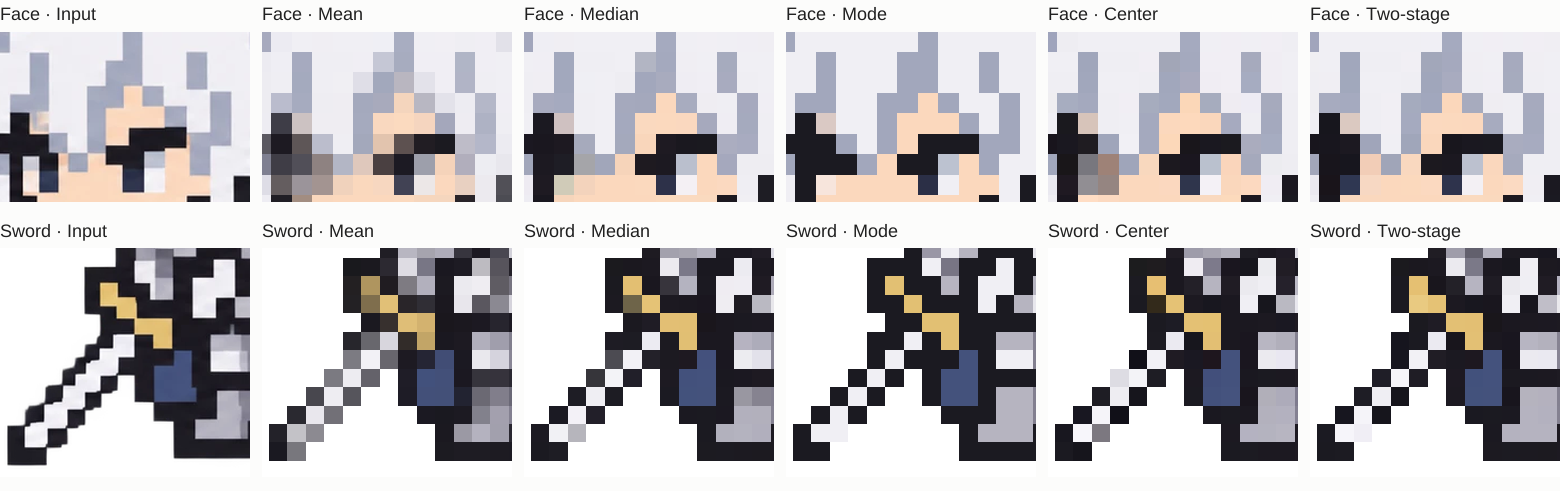
- 平均(mean):全部像素取平均。软边上最容易发灰,过渡色会混进来。格里菲斯上输出 486 种颜色,有 135 格和格子主色相差明显(ΔE > 10)。
- 中位数(median):红、绿、蓝各自取中位数。对零星杂点不敏感,但三个通道分开取,拼出来的颜色可能格子里根本没有。
- 众数(mode):取格子里出现最多的颜色。结果一定是格子里真实出现过的颜色。
- 中心点(nearest):只取格子正中心的一个像素。最快,但中心正好落在过渡色上时就错了,剑刃上能看到几格灰白。
- 两阶段(two-stage):先把整图量化成十几到几十种颜色,每格按中心加权投票决定属于哪一类;再只用原图里属于这一类的像素求平均,作为这一格的颜色。
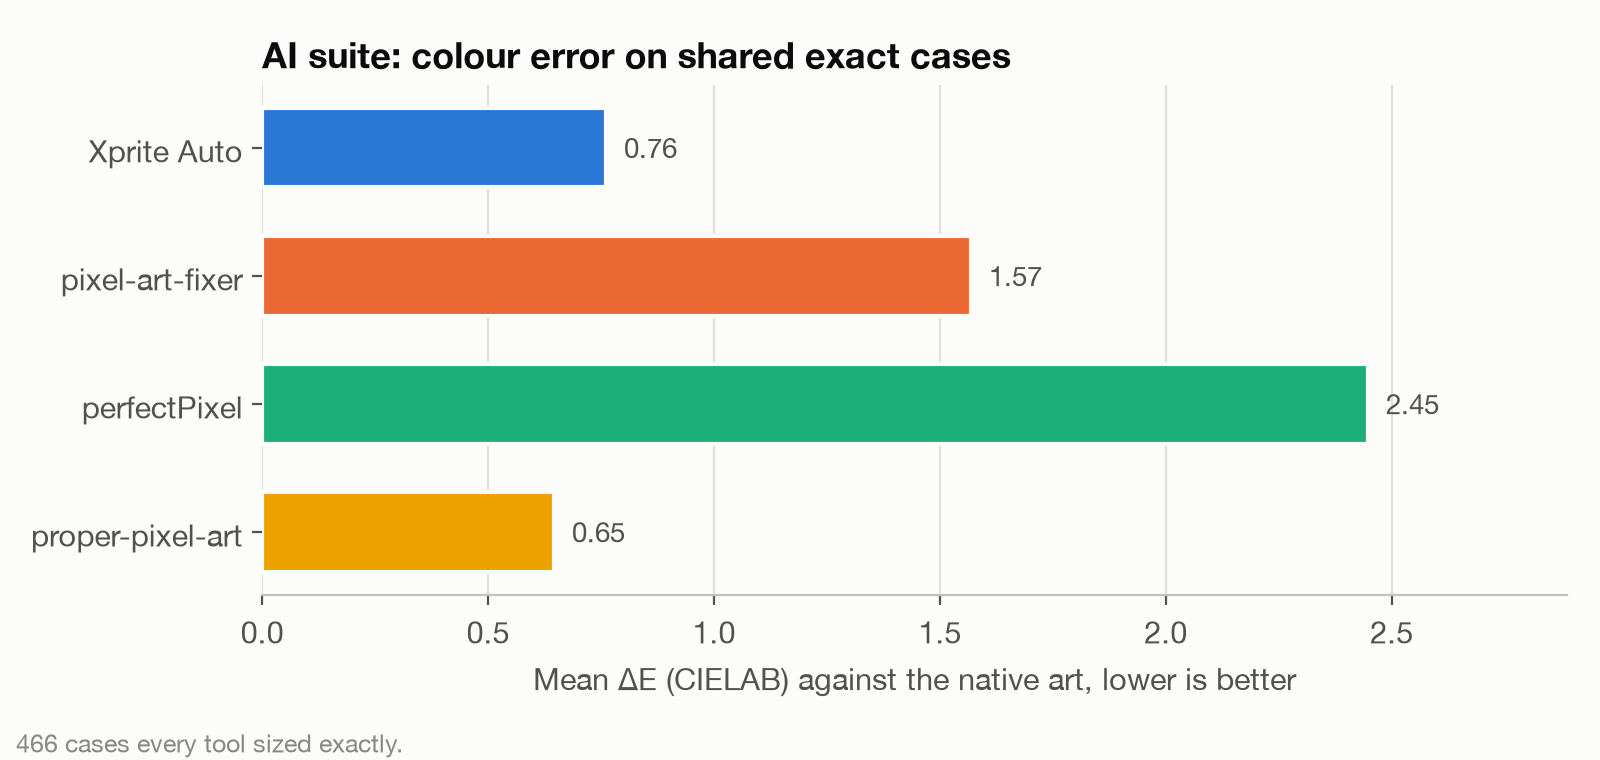
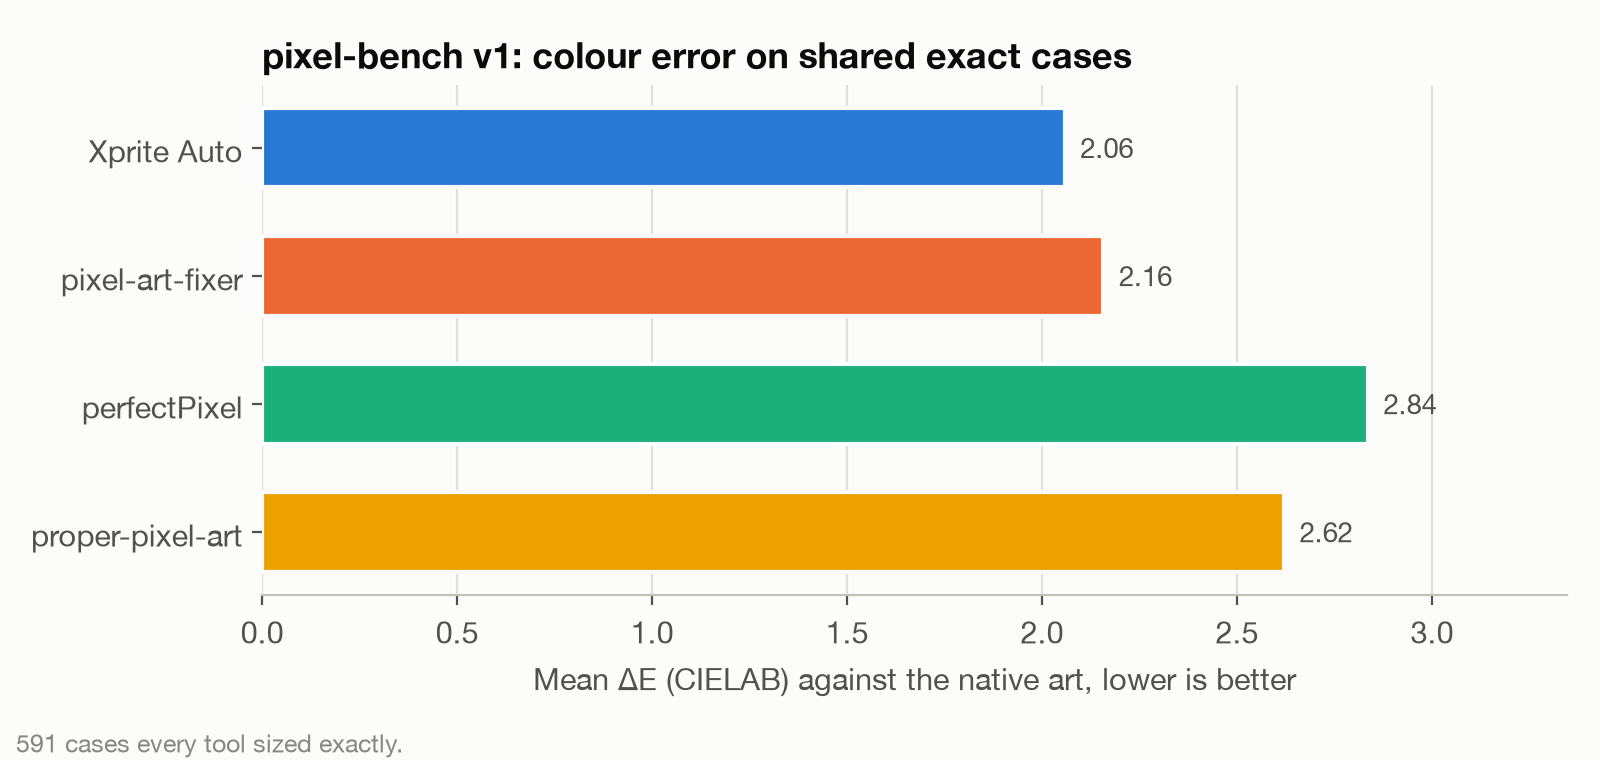
根据 benchmark(后面会讲)的反馈,最终我使用了两阶段进行取色。
颜色合并
在 CIELAB 里把几乎一样的颜色先归成一组,再按需要的颜色数做 k-means,聚类时让稀有颜色也能单独成为一类。
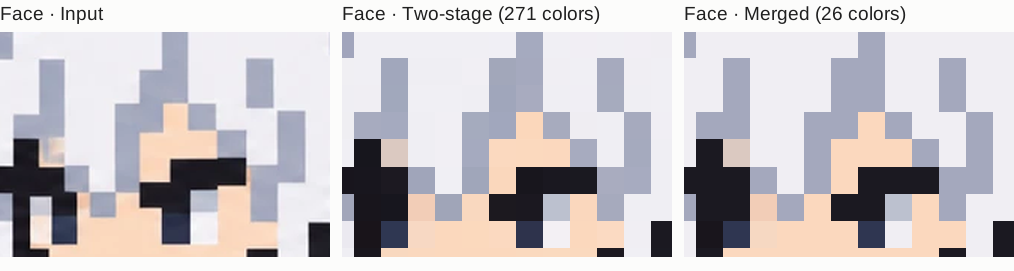
格里菲斯上,两阶段输出 271 种颜色,合并后剩 26 种,肉眼几乎看不出差别。
透明像素二值化
前面提到AI 图的轮廓可能存在半透明渐变。这里对他们进行二值化,透明度超过 50% 就完全透明,否则就按不透明走。
结果
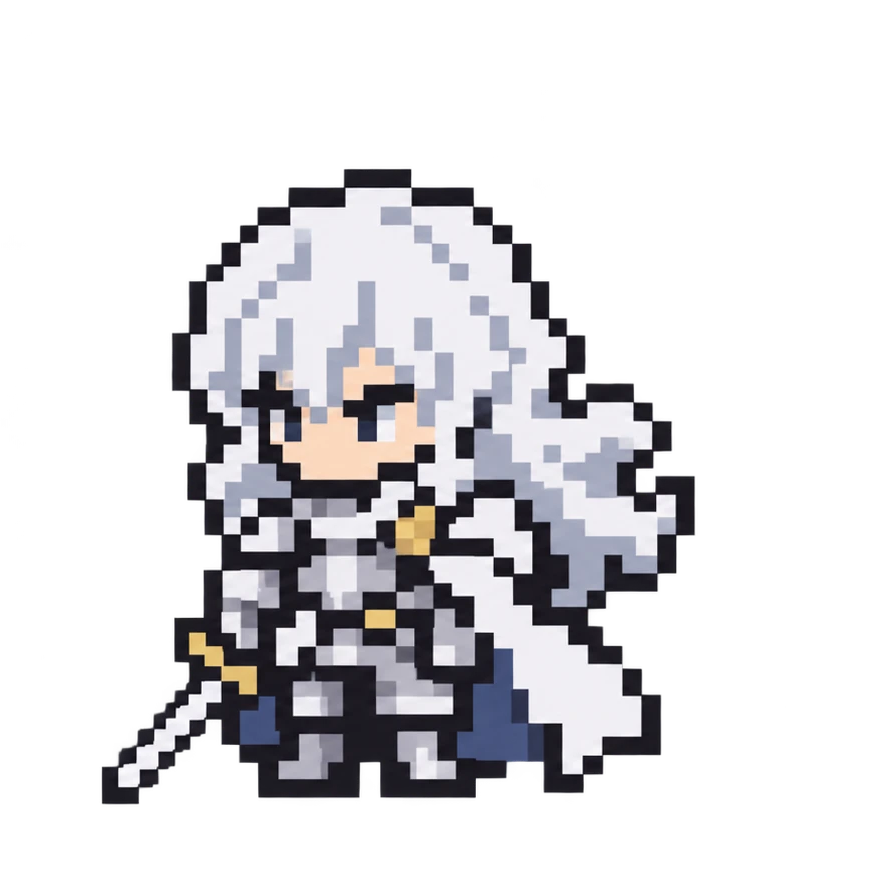
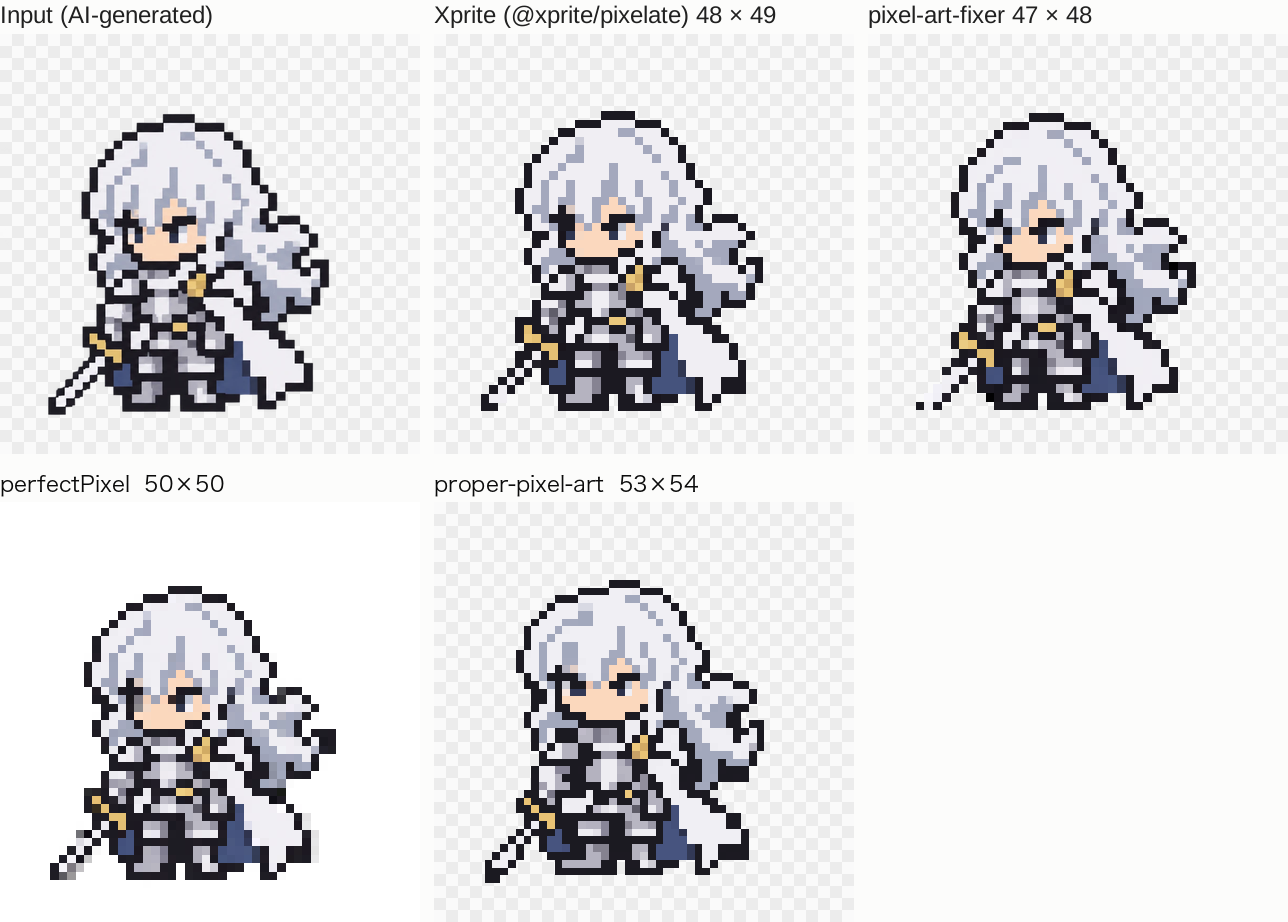
最后看看效果吧,除了单手剑上有个像素点的缺陷,其他地方是不是都还不错。
Benchmark
标题里,我提到这个方案可能是当前 SOTA 的开源方案,那必然得上评测来佐证了。
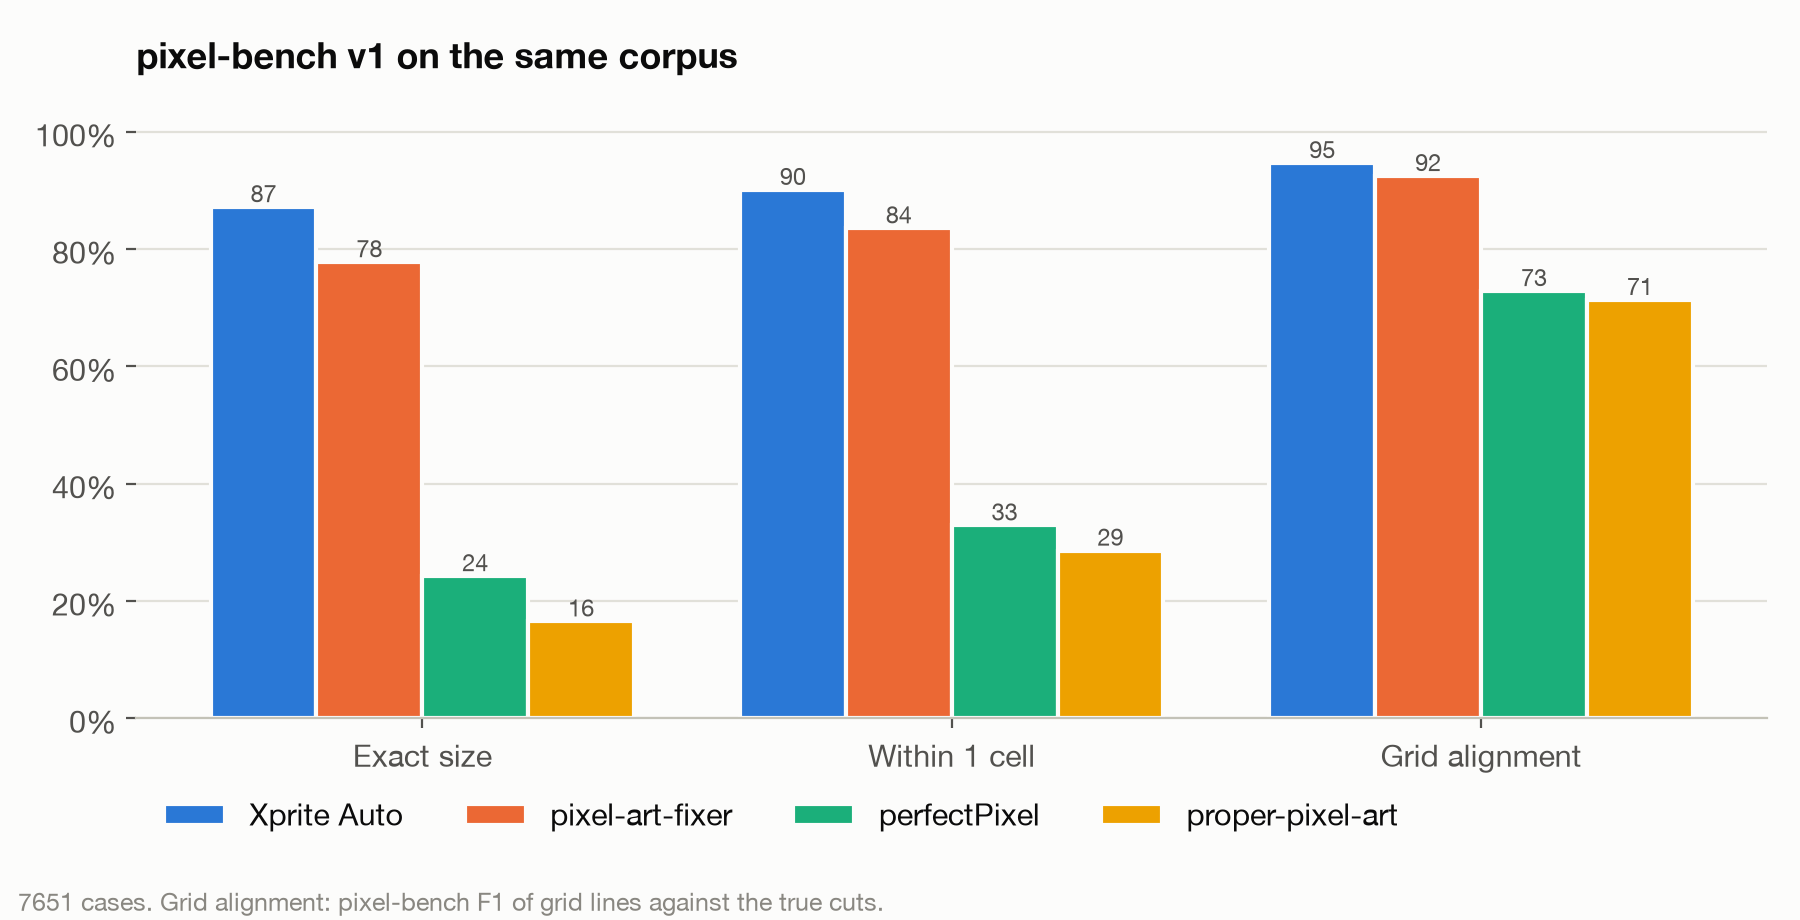
不过这块比较小众,找了很久也只看到一个 pixel-bench(和 fixer 是一家的,所以可以看到 fixer 在上面拿到的分很高)。它的原理是:
- 拿真实的原生像素图当输入。
- 用内置算法把它们弄成各种「假像素」损伤(放大、模糊、JPEG、漂移、AI mush 等)。
- 再测修复算法能不能把这些有问题的图还原回真实像素图。
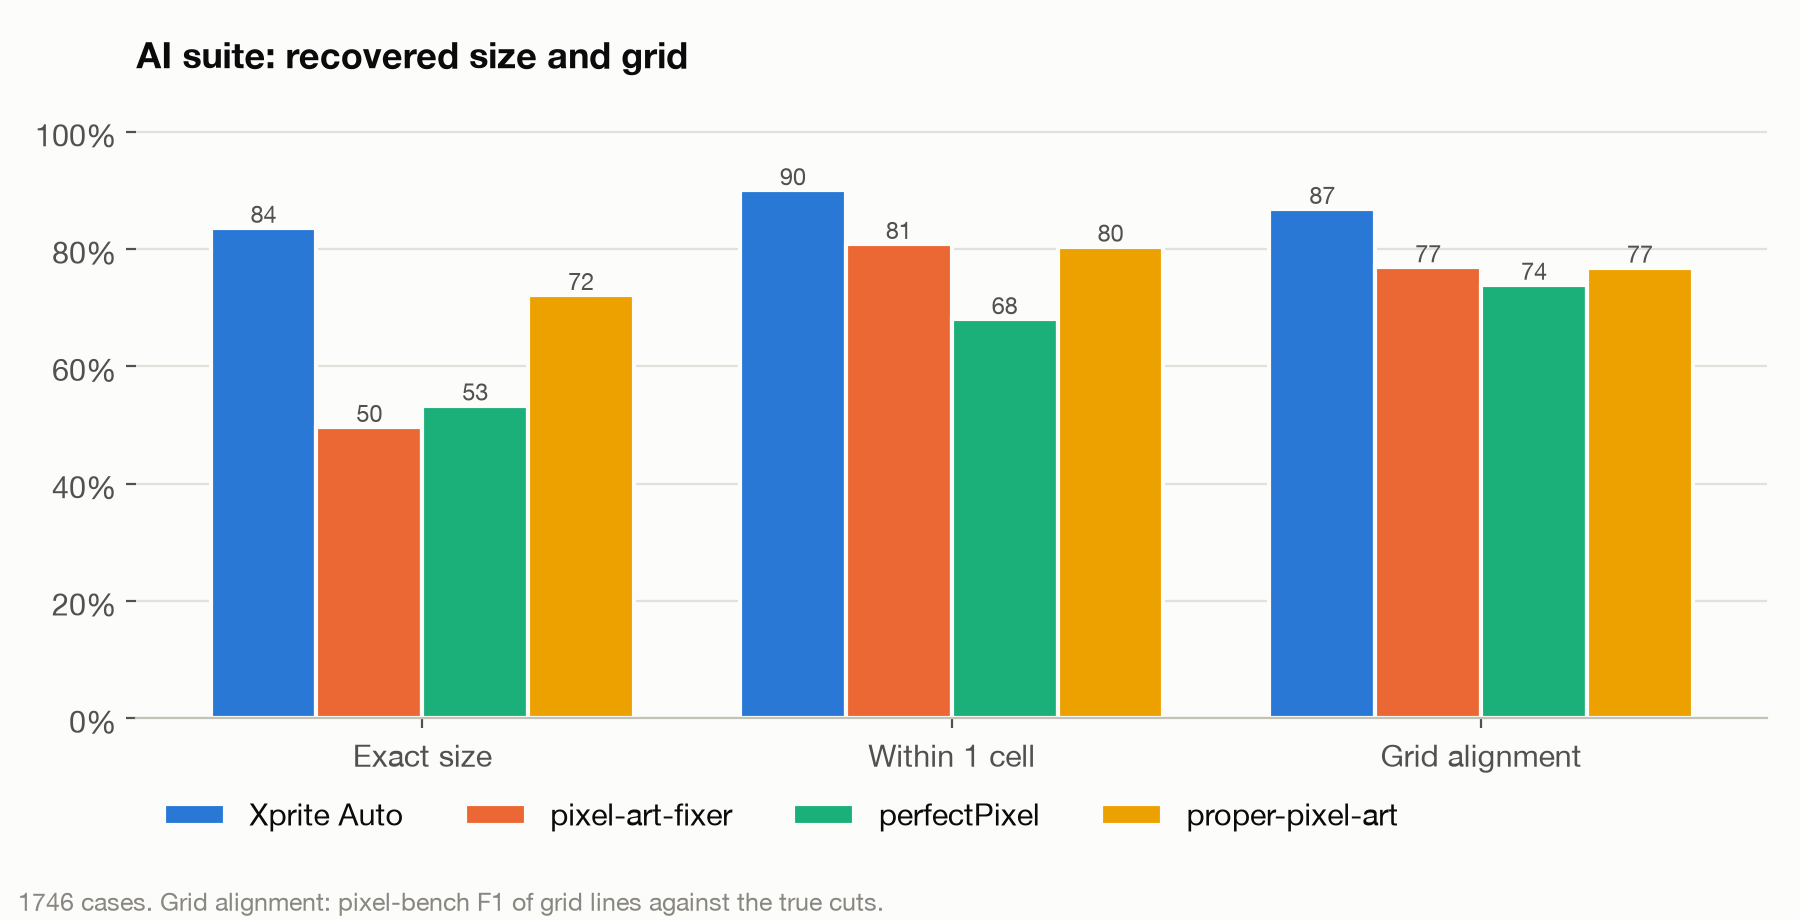
但实际使用下来,没法覆盖我之前遇到的半透明度、大留白、格宽漂移等问题。因此我在上面增加了一组假像素处理(ai_fake):
| 类别 | 模拟什么 |
|---|---|
| gen_clean | 软边、格内近乎平坦、格宽 8–20 |
| gen_sparse | 画只占画布的 20%–35% |
| gen_white | 灰白底代替透明 |
| gen_soft_edge | 3–5 像素的半透明描边 |
| gen_webp | 漂移、切割抖动、噪点、WebP |
| gen_halo_jpeg | 锐化光晕 + JPEG |
| gen_painterly | 格内笔触明暗 |
| gen_small_pitch | 格宽 4–8 |
| gen_large_pitch | 格宽 24–48 |
| gen_wobble | 强漂移 + 强抖动 |
| gen_pair | 一张画布上并排两个角色 |
| gen_shadow | 角色脚下半透明投影 |
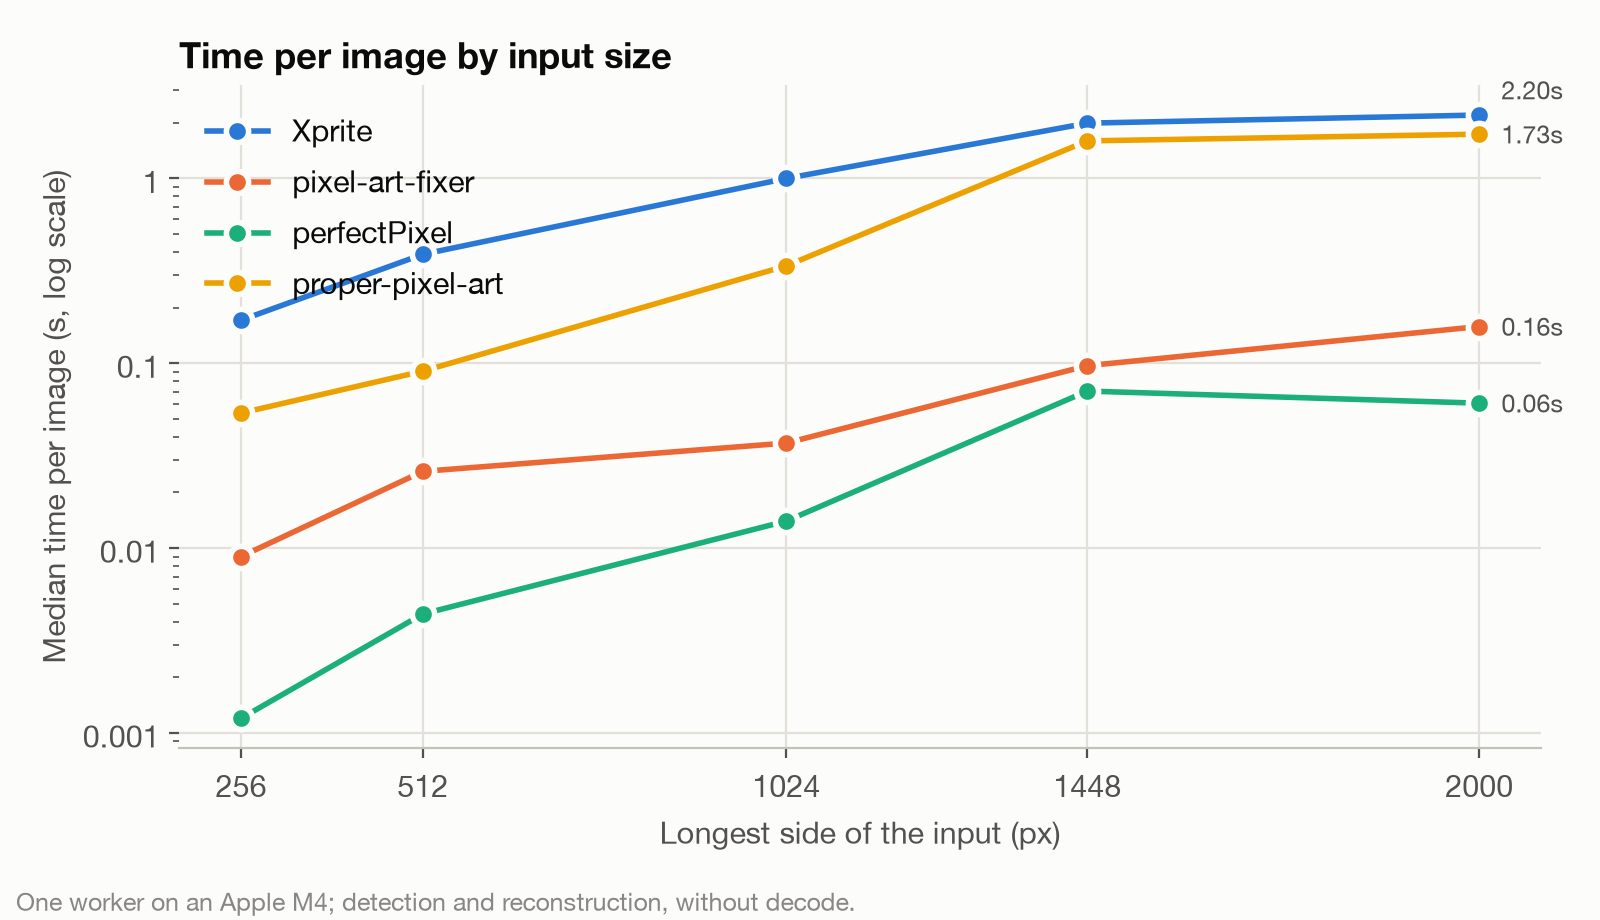
无论在原始 pixelbench 还是补充后的 AI 评测上,我的方案 Xprite Auto(因为放在我的 Xprite 网站里,作为自动模式预选,所以随便取了这个名字作为代号)取得了不错的成绩:
不过由于候选方案太多了,所以性能上目前是垫底 🧎🏻