XDoG 引导 PixelOE:把图片变成像素画
最近在研究程序化生成像素画的方式,用来作为底图方便手搓二次微调,这里记录一下研究过程。虽然程序化生成的效果肯定没法做到手搓的效果,但是对于色盘、轮廓还是有参考价值,在一些简易场景也能凑合用用。
直接缩小
我一开始直接缩小图片:先把图片缩小到 48×48,再放大回原来的尺寸查看。缩小有两种常见做法:
-
最近邻(nearest):每格只取一个点。线条上的点经常取不到,线条就断开了。
-
平均(box):每格取平均颜色。线条和周围的颜色混在一起,线条变淡了。
先加粗线条
线条在缩小的时候会断开或者变淡。办法是在缩小之前先把线条加粗。
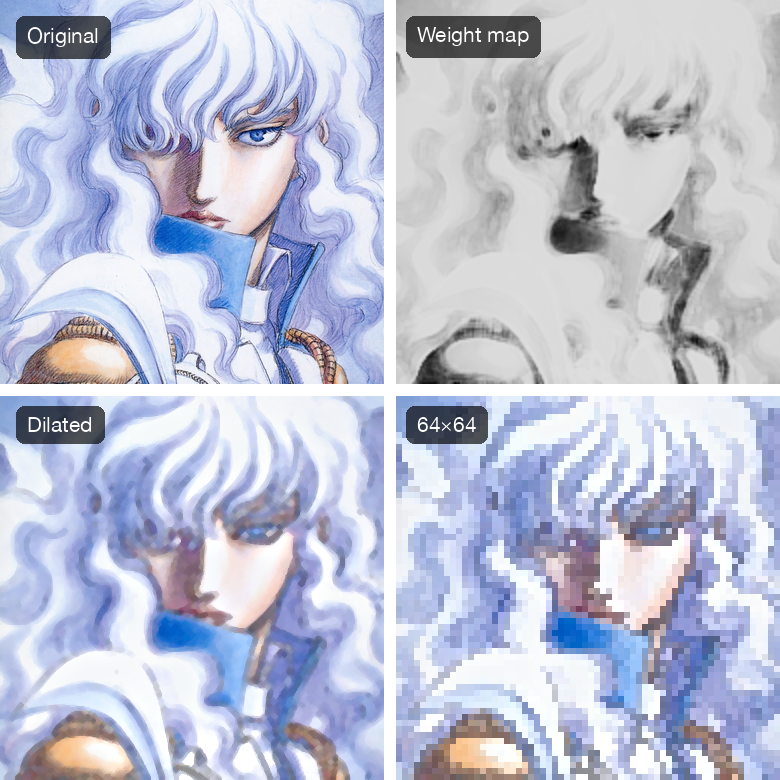
PixelOE 就是这样做的。它是 KohakuBlueleaf 写的开源像素化工具,分三步处理:
-
根据每一小块的亮度计算一张权重图。权重图越白的位置,深色越向外扩展。
-
把颜色调整回原图的颜色。
-
缩小。每格选一个点,格子里有特别暗或者特别亮的点,就优先选它。
加粗的问题
PixelOE 只根据亮度决定哪里加粗,它不知道线条在哪里。Griffith 这张图片整体很亮,权重图大部分是浅色,深色几乎在每个位置都向外扩展。
放大眼睛附近来看:
-
眼睛只剩下一点浅蓝色
-
眼线断开了
-
脸侧的阴影变成了灰紫色
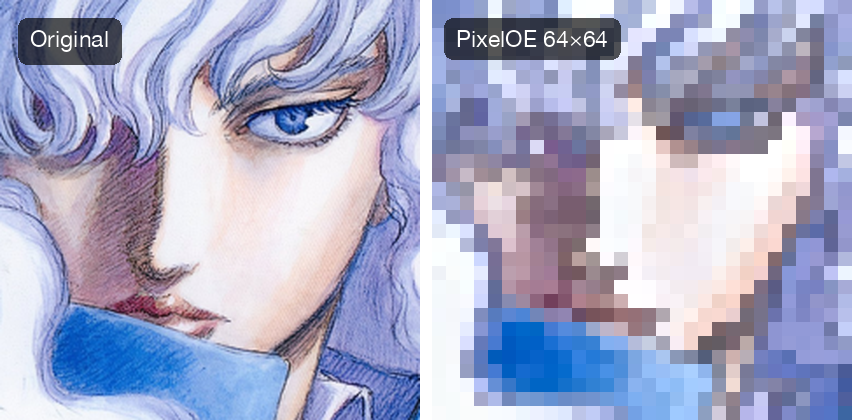
PixelOE 需要知道线条的位置。
加入线稿
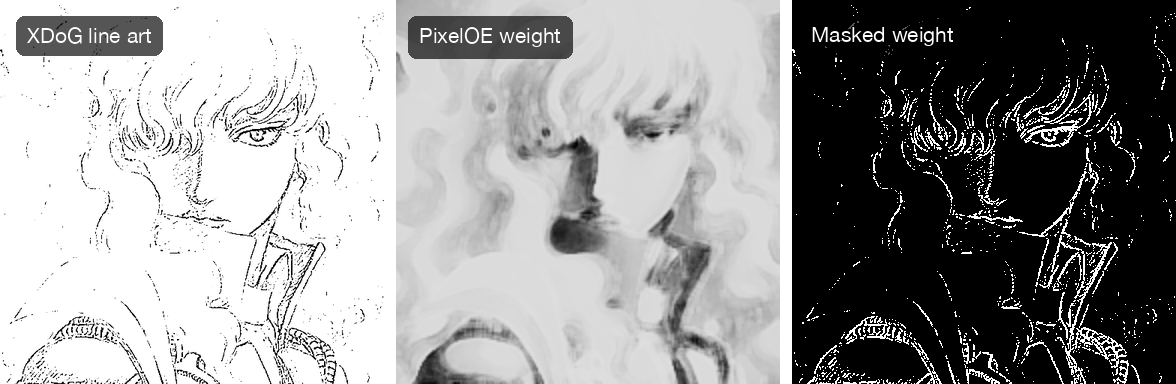
PixelOE 不知道线条在哪里,我就先提取一张线稿交给它:
-
用 XDoG 提取线稿。XDoG 把图片模糊两次再相减,然后取阈值。这张图片只需要几毫秒。
-
把线稿转换成黑白掩码。
-
用掩码替换权重图,只让线条上的深色向外扩展。
为什么用 XDoG
除了 XDoG,我还比较了三个 AI 模型提取的线稿:
- XDoG:经典图像处理算法,把图片模糊两次再相减取阈值,几毫秒出结果,不依赖模型。
- TEED:轻量级边缘检测 Transformer,兼顾速度和精度,适合实时场景。
- PiDiNet:像素差分卷积网络,用传统边缘算子思路做 CNN,参数量小。
- Anime2Sketch:专门为动漫图训练的草图提取模型,线条最接近手绘,但模型有 218MB。
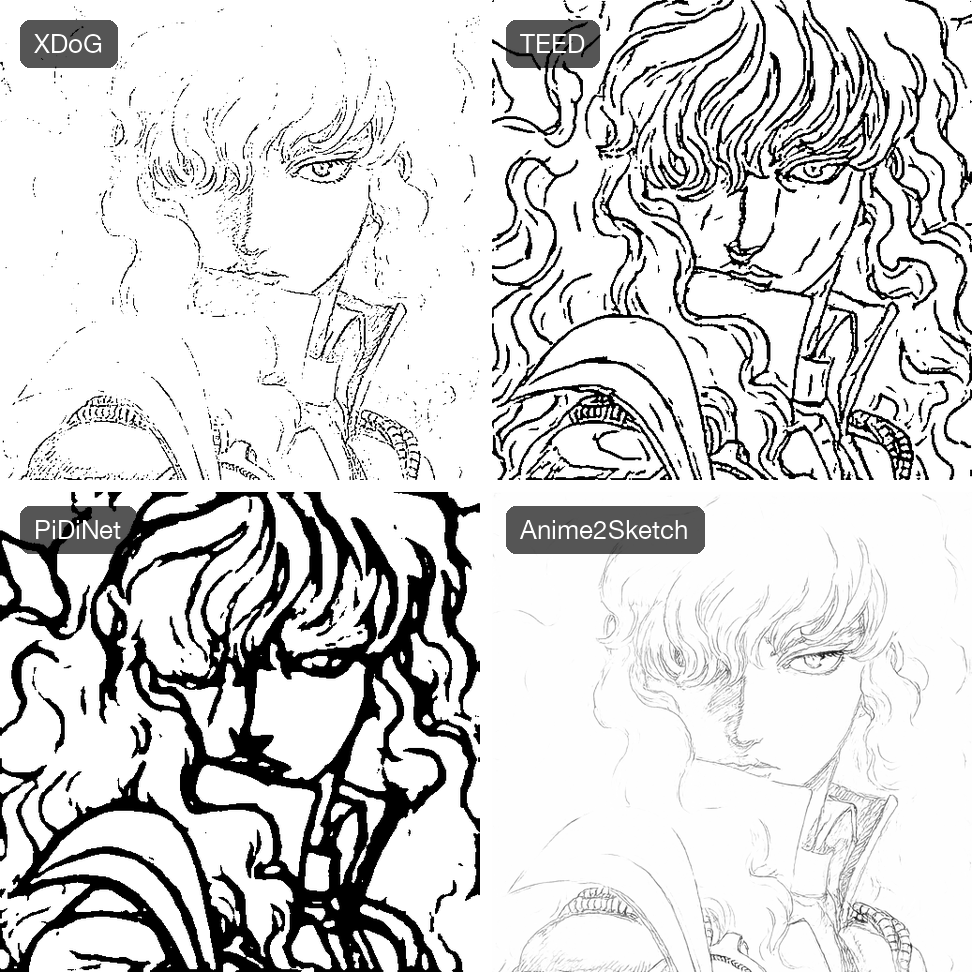
Anime2Sketch 最接近手绘,但模型放进网页太大,所以我选了 XDoG。
64×64 对比
下面比较 PixelOE 默认参数(thickness=2)和加了线稿的版本,先看 64×64。
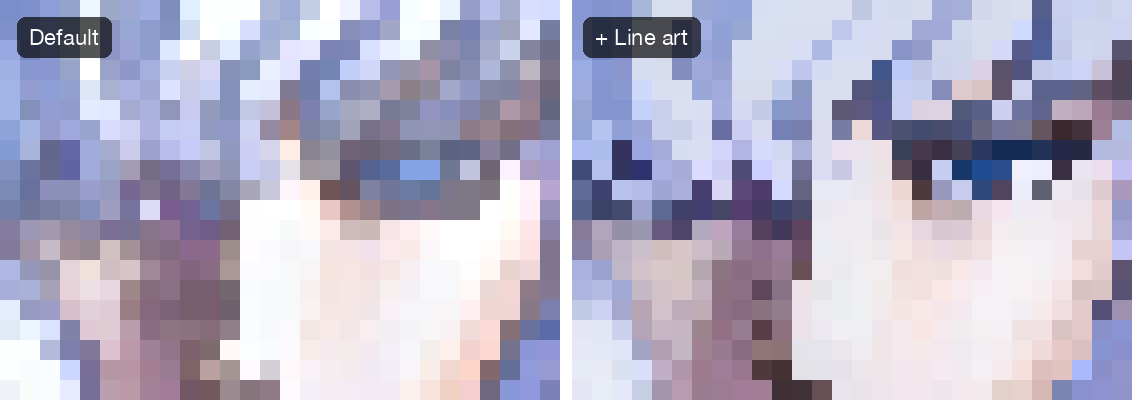
加了线稿以后:
-
眼睛上方出现了一条连续的深色眼线
-
鼻梁和下巴的线条更清楚
-
衣领右边多了几道深色碎线
48×48 对比
再缩小到 48×48。
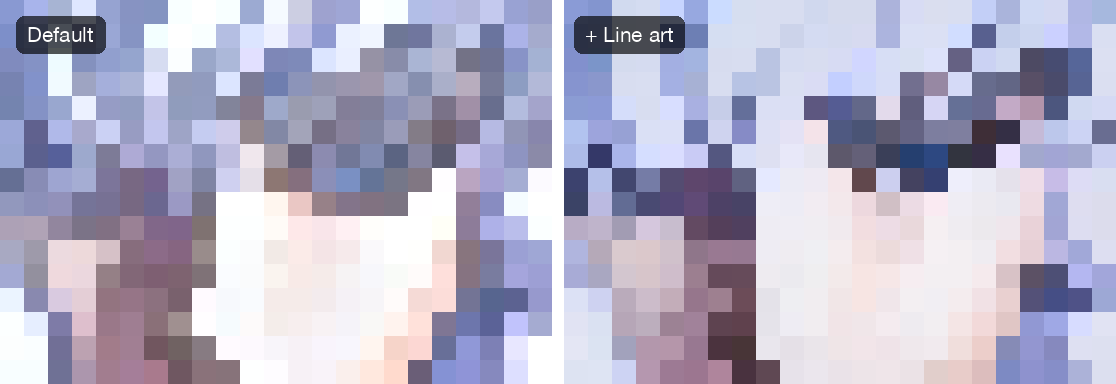
默认版本里,眼睛和头发的颜色混在一起,分不清边界。加了线稿以后,还能看出眼睛的位置。衣服上的黑点比 64×64 更多。
先平滑再缩小?
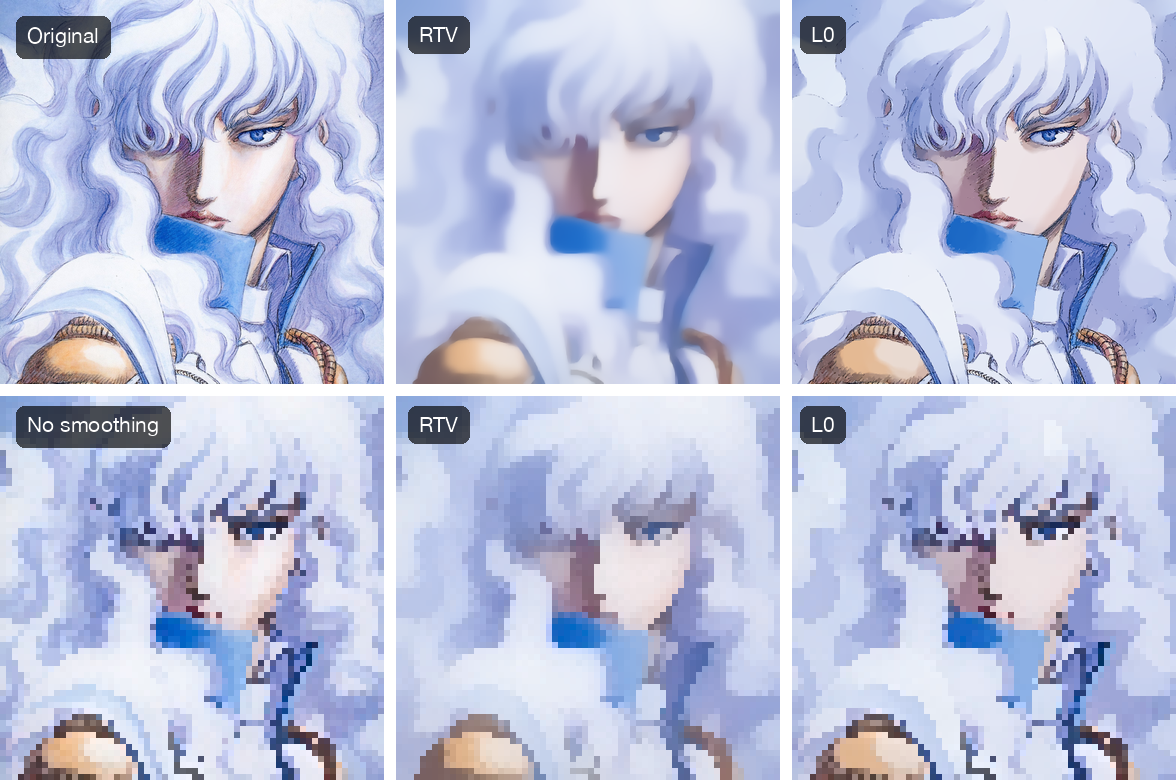
缩小之前先平滑图片,会不会更好?这两种算法都会保留大块的颜色、去掉细小的纹理:
我把线稿和平滑分开处理。XDoG 线稿从原图提取,掩码同样替换权重图。PixelOE 在平滑以后的图片上加粗和缩小,所以平滑只影响颜色。
-
RTV 去掉了图片里的深色线条。加粗只能扩展已有的深色,掩码标出的位置没有深色可以扩展,眼线变成了一片灰蓝色。
-
L0 保留了线条。头发的色块平整了一些,其他部分和不平滑的版本几乎一样。
结论:要不要先平滑,取决于图片的场景和画风。为了在放大和缩小的各种场景下都有较高的辨识度,我还是建议用 XDoG。